AI 生成了 100 条测试用例,怎样判断里面有多少是真正有效的?
AI 一口气生成 100 条用例,数字很好看,但真正能用的有多少?本文给出一张从需求可追溯、可执行性到结构合理性的检查表,帮你从数量里筛出有效用例。
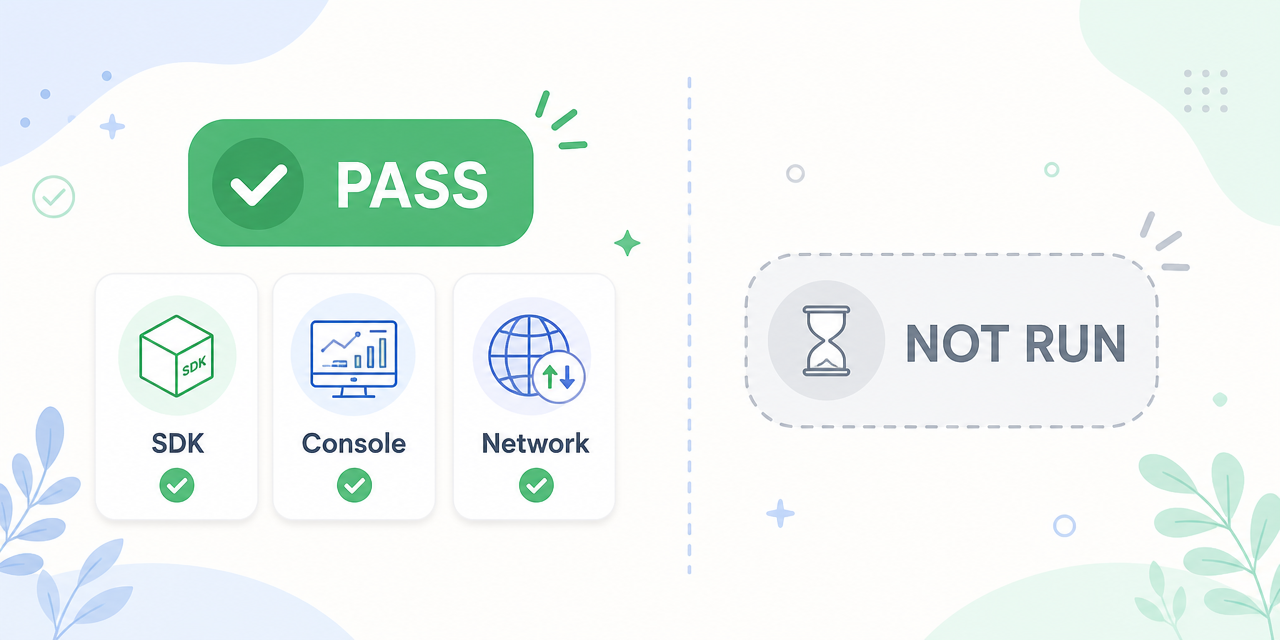
12 条 Pass、8 条 Not Run,为什么最终仍能判断埋点通过?
埋点验收出现 12 条 Pass、8 条 Not Run 时,为什么不能简单算出 60% 通过率就下结论?本文讲清 Pass/Fail/Blocked/Not Run 四态的判定边界,以及"没跑到"和"跑挂了"为什么必须分开。
自动化用例通过了,为什么我仍然不敢说功能没问题?
自动化用例全绿,只能证明特定条件下的实际结果符合断言。本文用执行、断言、覆盖和业务结论四层模型,分析“假绿”从哪里产生,以及测试人员怎样给出有边界的质量结论。
一个超长 ID,为什么到了前端就变了?埋点验收中发现的 JavaScript 精度坑
一次埋点验收中,接口返回的超长 ID 到了前端却发生变化。本文从真实排查过程出发,讲清安全整数、JSON 解析、接口契约、前端防御和边界测试。
埋点验收中途换手机,怎样保证证据链不断?
结合一次中途更换 Android 真机的埋点验收实践,讲清如何保留同一验收任务、重建采集窗口,并用设备段、证据索引和结论历史保证结果可追溯。
排行榜测试数据怎么造?阈值、并列、Top N 与邀请关系实战
结合一次脱敏的排行榜测试实践,讲清如何围绕参与资格、阈值、并列、Top N、邀请关系和多内容竞争设计可验证的测试数据。
🔗 让链接显示成可读文字:平台抓标题 + 企业微信通知的两步优化
分享在测试平台里让链接显示成可读文字的两个场景:平台内外部链接抓网页标题(含 SSRF 防护),以及企业微信通知从 text 消息升级为 markdown 消息让链接显示成文字。
把 JMeter 接入测试平台:让压测只在受控执行服务器运行
记录将 JMeter 集成进测试平台的工程实践:由平台管理 JMX、CSV 和参数,在受控执行服务器启动、监控、取消并回收压测结果。
让 AI 根据 HTTP 抓包编写 JMeter 业务链:能自动化什么,必须人工确认什么
基于真实实践说明 AI 如何把 HTTP 抓包整理为可维护的 JMeter 业务链 JMX,以及结构校验、最小执行和人工判断之间的边界。
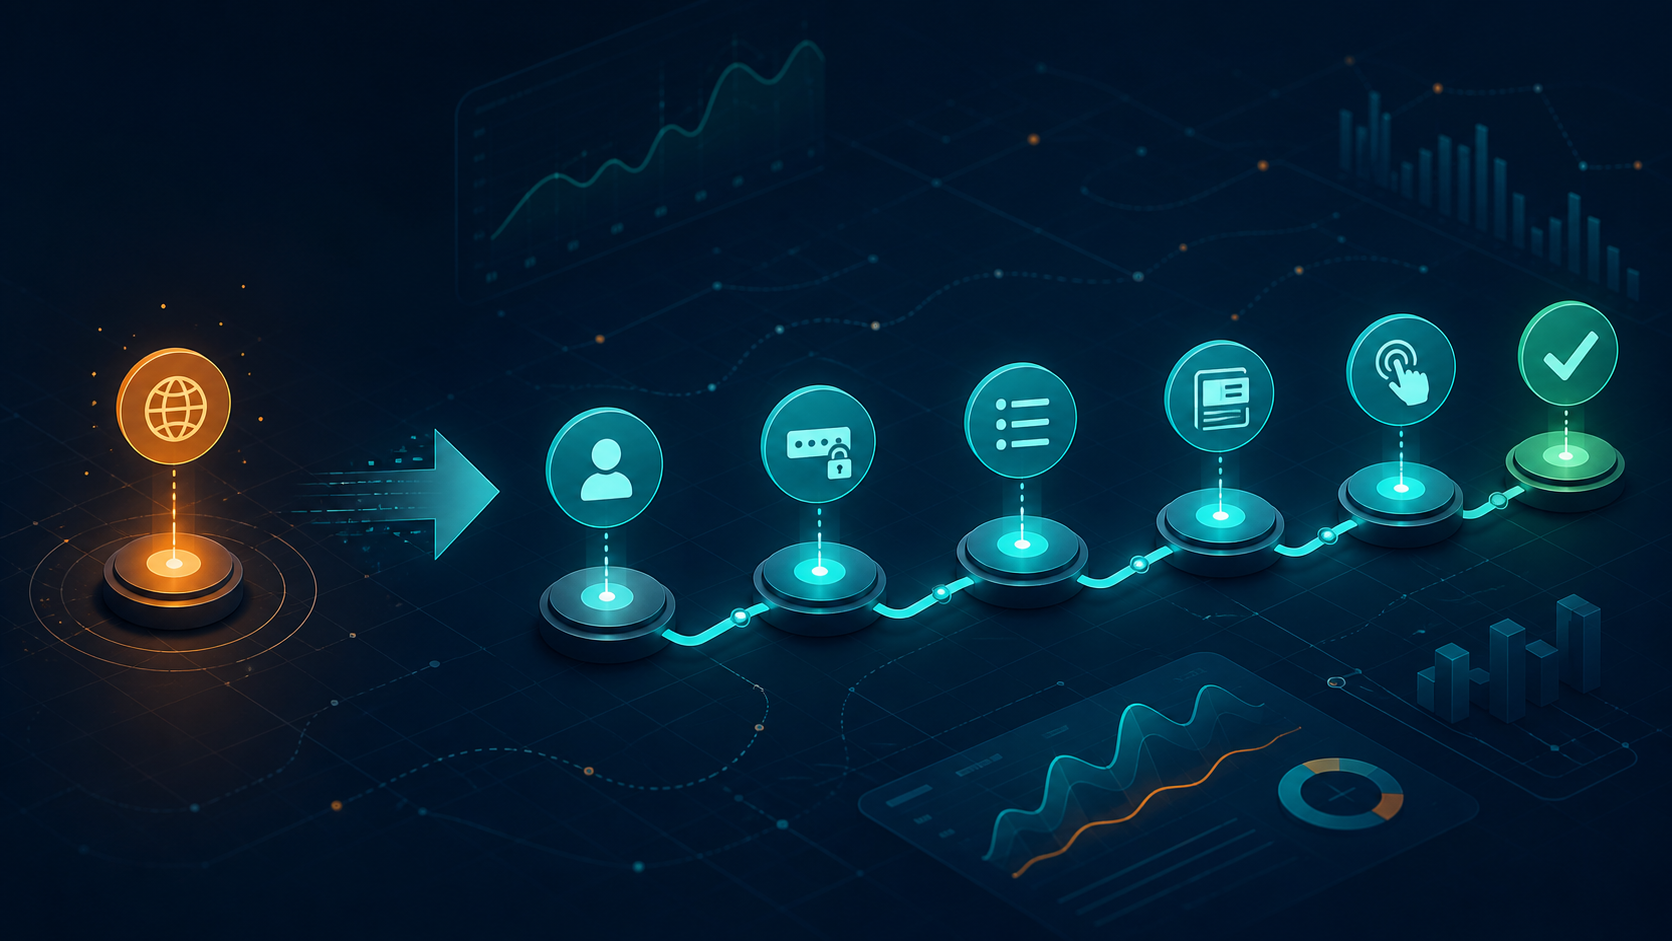
从单接口到完整业务链:用一个案例学会 JMeter 业务压测设计
以登录、浏览列表、打开详情和点赞为完整示例,带你从业务目标、JMeter 测试计划、动态参数和负载计算一路做到执行与结果判断。
先用通用 Agent,还是自己写 Agent?我的实践判断框架
从真实 AI 协作实践出发,判断什么时候直接使用通用 Agent,什么时候沉淀 Skill、Tool、Harness,什么时候才值得建设自己的 Agent 系统。